주말 동안 새로 붙잡은 게임은 닌텐도 DS용 《모여라! 파워프로군의 DS 코시엔》이다. 처음에는 그래픽 포맷을 몇 개 풀고 일본어 문자열을 검색하면 대략적인 규모가 보일 줄 알았다. 결론부터 말하면 그렇게 간단하지 않았다. 이 게임은 흔히 보이는 닌텐도 표준 리소스 대신 코나미 자체 포맷을 잔뜩 사용하고 있었고, 텍스트도 평범한 Shift-JIS 문자열로 들어 있지 않았다.
그래서 이번 주말은 번역보다도 먼저, 게임이 데이터를 읽고 화면에 표시하는 길을 코드에서 확인하는 데 거의 전부를 썼다. 중간에 그럴듯한 결과를 너무 빨리 정답이라고 생각했다가 다시 되돌아간 일도 많았다. 그래도 마지막에는 그래픽과 글자가 실제로 어디서 어떻게 표시되는지, 번역 대상을 어떤 방식으로 뽑아야 하는지까지 연결됐다. 한글 패치 제작 전 구조 분석은 이쯤에서 1차 완료로 잡아도 될 것 같다.
먼저 롬의 뼈대부터
대상 롬의 게임 코드는 APXJ, 내부 타이틀은 PP KOUSHIEN2다. 64MB 롬 안에는 ARM9 본체와 44개의 오버레이, 5천 개가 넘는 파일이 들어 있다. ARM9과 오버레이가 모두 비압축이라는 점은 반가웠다. 나중에 코드를 고칠 때 압축 해제와 재압축 단계를 거치지 않아도 되기 때문이다.
반면 리소스 쪽은 예상보다 독특했다.
| 종류 | 개수 | 현재까지 확인한 내용 |
.cbb |
894 | 16비트 그래픽 압축. 디코드·재인코드 894개 전부 원본 바이트와 일치 |
.cdb |
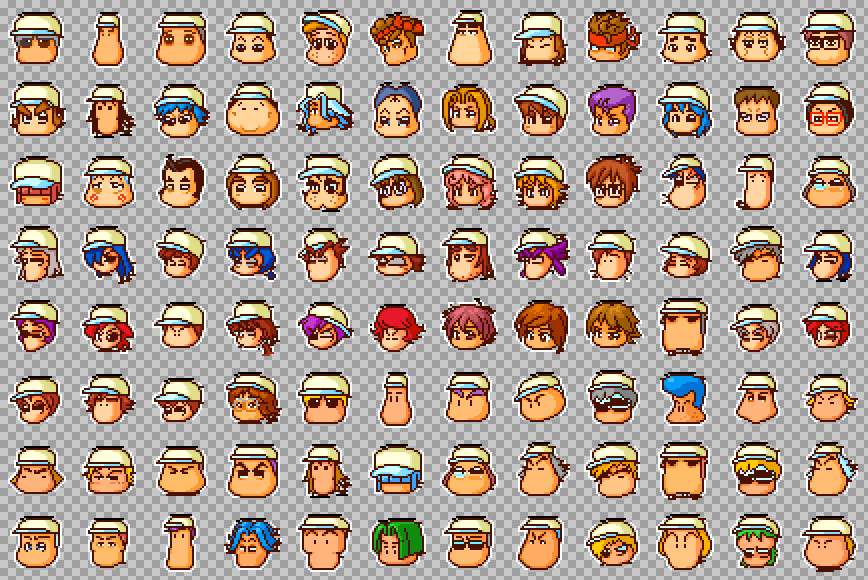
4,046 | 얼굴 파츠와 아이콘 중심의 4bpp 타일. 4,006개 구조 확인, 깃발 계열 40개는 추가 조사 필요 |
.bmb |
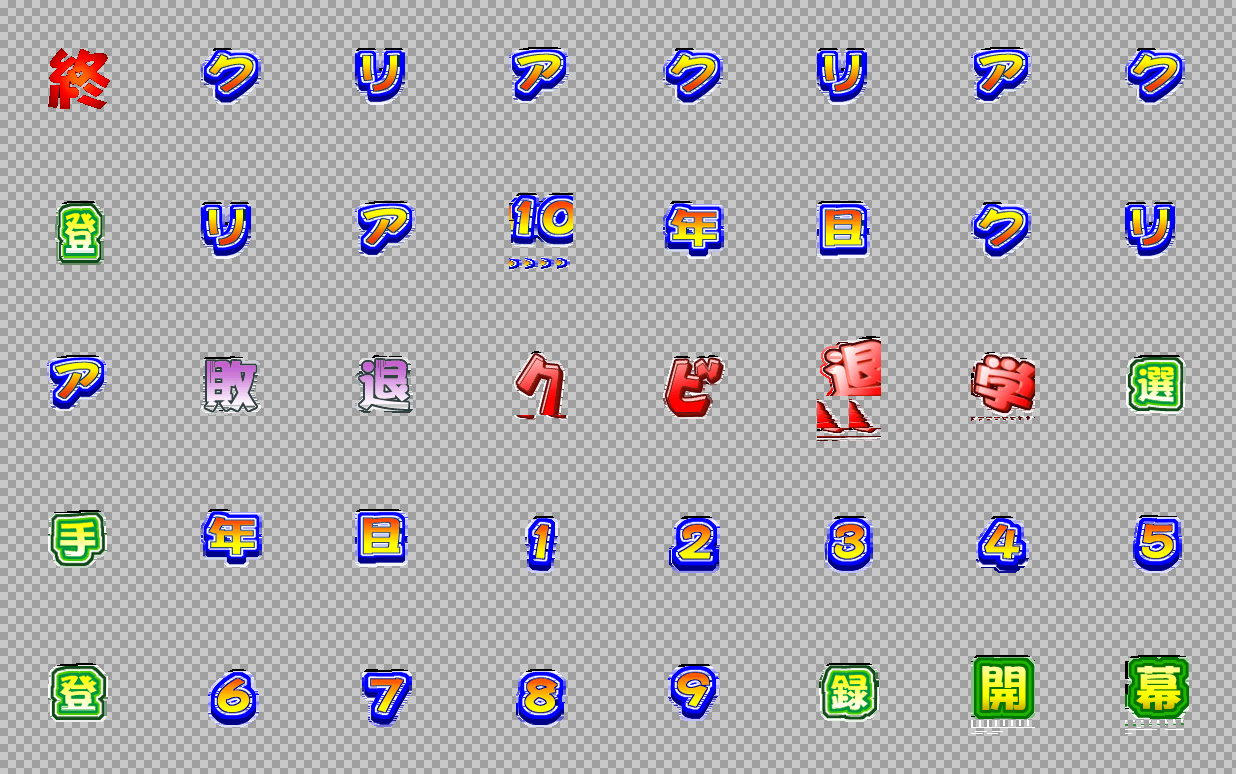
255 | 화면·배경 계열. 압축형 172개는 크기와 픽셀 수까지 일치, 나머지 경로는 더 확인 중 |
.pbn |
13 | 깃발 등의 색을 조합하는 16비트 색상표 |
제일 오래 걸린 것은 “그럴듯함”을 버리는 일이었다
초반에는 파일의 숫자 패턴과 렌더 결과를 보고 포맷을 추정했다. 몇몇 아이콘은 꽤 정상적으로 보여서 금방 풀었다고 생각했다. 그런데 코드의 실제 디코더를 따라가 보니 반복 토큰 하나를 잘못 해석했고, 분기 하나는 통째로 빠뜨리고 있었다. 하필 흰색 외곽선에서는 잘못된 방식으로 풀어도 얼핏 맞아 보여서 더 오래 속았다.
결국 방향을 바꿨다. 화면이 그럴듯한지를 먼저 보지 않고, 파일을 여는 함수에서 시작해 압축 해제 루틴과 VRAM 복사까지 어셈블리를 차례로 이어 갔다. 그 결과 .cbb의 토큰 규칙을 확정했고, 역방향 인코더까지 만들어 894개 파일을 전부 디코드 → 인코드했다. 결과는 894/894 바이트 단위 일치, 총 크기 차이 0바이트였다. 이번 주말의 가장 확실한 성과다.
.cdb도 같은 방식으로 풀었다. 일반형은 팔레트 블록과 해제 크기, RLE 스트림으로 구성되고, mpk 계열은 팔레트 없이 순수 RLE 스트림만 들어 있었다. 얼굴의 모자·눈·머리·피부 파츠가 정상적으로 분리되어 나왔고, 일반형 3,848개와 별도형 158개까지 총 4,006개의 읽기 구조를 확인했다. 다만 읽을 수 있다는 것과 다시 넣을 수 있다는 것은 다른 문제다. .cdb와 .bmb의 인코더는 아직 만들지 않았으므로 그래픽 한글화가 끝났다고 할 단계는 아니다.
텍스트는 검색이 아니라 출력 함수를 따라가야 했다
텍스트 쪽은 더 심했다. 이 게임의 문자 인코딩은 거의 모든 바이트를 유효한 문자처럼 받아들인다. 그래서 롬 전체를 자동 검색하면 19,779개의 문자열 후보가 나오고, 포인터처럼 보이는 것만 골라도 6,942개가 남았다. 처음에는 엄청난 대사량이라고 생각했지만 대부분은 데이터가 우연히 문자처럼 해석된 잡음이었다.
가장 웃겼던 오탐은 ARM9에서 발견한 751개짜리 거대 문자열 표였다. UI 문구 모음인 줄 알았는데 코드를 끝까지 따라가 보니 AHO, BAKA, BOKE, AIDS, ANUS 같은 단어가 알파벳순으로 늘어서 있었다. 정체는 이름 입력 때 쓰는 금지어 블랙리스트였다. 화면에 출력되는 문장도 아니고 번역 대상도 아니었다.
또 오버레이 33에서 3천 개가 넘는 한자를 읽어 냈을 때도 대사 사전을 찾았다고 생각했다. 하지만 같은 읽기의 한자가 묶여 있는 구조와 호출 경로를 확인하니, 이것은 이름 입력용 가나→한자 변환 사전이었다. 자동 추출 숫자만 믿었으면 며칠을 엉뚱한 곳에서 보낼 뻔했다.
그래서 렌더러 호출부에서 문자열 인자가 어디서 오는지를 역으로 추적했다. 이 방법으로 오버레이 34의 실제 경기 대사와 오버레이 7의 훈련 메뉴를 확인했다.
勝たせて頂きますよ〜!
よろしくお願い致します。
やりました! / ホームランですよぉ!
打撃練習をさせる
やっぱり変更しない
이후 코드에 직접 보이는 표만 찾는 방식에서, 연속된 문자열 포인터 구조 자체를 찾는 방식으로 추출기를 다시 만들었다. 전역 구조체를 거쳐 간접 참조되는 대사와 곡명·음식명처럼 앞 방식에서 빠졌던 문자열도 되살렸다. 반대로 포인터가 가리키는 문자열 영역이 서로 겹치면 데이터 오독으로 판단해 배제했다.
최신 추출본 기준으로 35개 모듈, 397개 테이블, 4,500줄이 잡힌다. 이것을 그대로 번역 분량이라고 부르기는 어렵다. 이 게임의 인코딩은 바이너리 데이터도 일본어처럼 해석할 수 있어 일부 후보는 사람이 확인해야 하고, 같은 문장의 중복도 있기 때문이다. 중요한 것은 이제 추측성 전체 검색이 아니라, 게임의 문자열 구조를 따라 반복 가능한 형태로 다시 뽑을 수 있게 됐다는 점이다.
폰트와 문자 출력 구조
폰트는 12×12 픽셀, 2bpp, 글자당 36바이트 구조였다. 처음에는 목적지 VRAM의 32바이트 타일 크기를 보고 16×16 1bpp로 착각했고, 단순 배열로 그리자 줄무늬만 나왔다. 글리프를 가져오는 함수의 뱅크 계산과 행 스트라이드를 그대로 옮기고, 놓쳤던 세 번째 4픽셀 열까지 찾고 나서야 한자가 정상적으로 읽혔다.
문자표에는 255개의 가나·기호·전각 문자가 있고, 한자는 약 4천 자의 글리프 인덱스를 직접 사용한다. 색상 변경 제어코드와 글자 폭 계산도 코드에서 확인했다. 이제 문자 코드 → 글리프 인덱스 → 12×12 비트맵 → 화면 출력 경로는 이어졌다.
다만 추출한 한자를 유니코드 문자로 표시할 때 일부 구간이 한 칸씩 어긋나는 문제가 남았다. 게임 화면에는 ‘도루(盗塁)’가 제대로 나오는데 추출 결과만 ‘盗涙’처럼 표시되는 식이다. 폰트 비트맵을 표준 JIS 글꼴과 대조해 인덱스표를 다시 만들면 해결할 수 있을 것으로 보고 있다.
지금 어디까지 왔나
| 항목 | 상태 |
| 롬·오버레이·파일 로딩 구조 | 기본 경로 확인 |
.cbb 읽기와 쓰기 |
894/894 원본 바이트 일치로 검증 완료 |
.cdb 읽기 |
4,006/4,046 확인, 40개 예외 남음 |
.bmb 읽기 |
압축형 172개 확인, 나머지 구조 정리 필요 |
| 폰트 | 12×12 2bpp 구조와 렌더 경로 확인 |
| 텍스트 추출 | 35개 모듈·397개 테이블·4,500줄 후보를 구조적으로 추출 |
| 한글 한 글자 교체 실험 | 아직 미실시 |
| 문자열 재배치·포인터 수정 | 아직 미착수 |
무수정 롬을 다시 빌드했을 때 원본과 달라지는 문제도 확인했다. 파일 위치가 바뀐 것은 아니고, 파일 사이 패딩이 00에서 FF로 바뀌고 64MB 끝의 여유 영역이 잘린 것이 원인이었다. 따라서 앞으로는 롬 전체를 새로 조립하지 않고, 원본 이미지의 같은 위치에 데이터를 덮어쓰는 방식으로 진행한다. 데이터가 커질 때만 뒤쪽 여유 공간으로 옮기고 FAT 항목을 수정할 계획이다. 이쪽이 원본 보존과 작은 xdelta 패치 제작에도 유리하다.
분석은 여기까지, 이제 제작 단계로
이제부터는 새로운 포맷을 계속 추측하는 것보다, 확인된 경로를 실제 패치 도구로 연결하는 일이 중요하다. 구조 분석은 1차 완료로 닫고 다음부터는 한글이 화면에 나오는 결과물로 진도를 판단하려 한다.
- 한자·반각 글리프의 유니코드 라벨을 이미지 대조로 바로잡는다.
- 추출된 4,500줄 후보에서 데이터와 중복 문장을 사람이 분류한다.
- 폰트 한 글자를 한글로 교체해 에뮬레이터 화면에서 확인한다.
- 문자열 재배치와 포인터 수정의 최소 실험을 만든다.
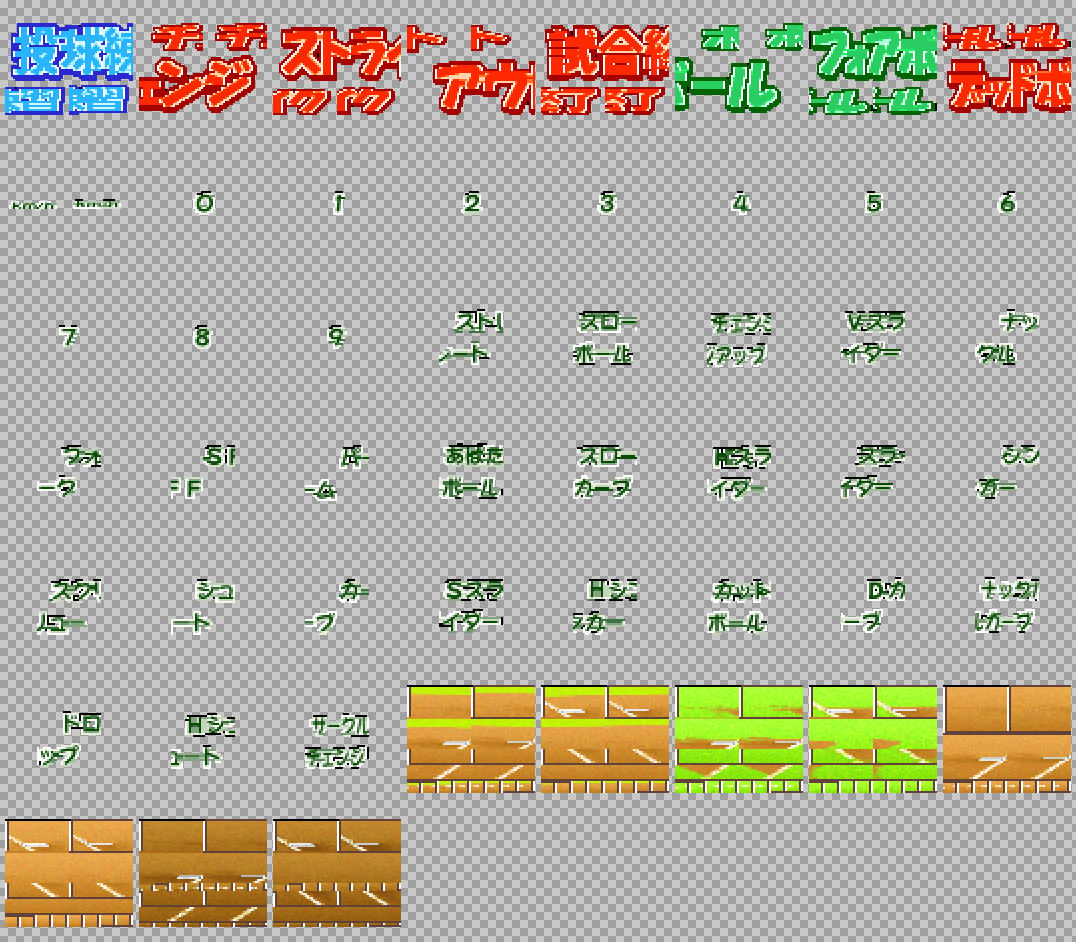
.cdb·.bmb재삽입 도구와 제자리 패처를 만든다.- 이미지 갤러리에서 배경에 박힌 일본어도 별도 번역 대상으로 분류한다.
주말 내내 여러 번 틀렸지만, 틀린 가설을 문서에 남기고 코드로 하나씩 지워 낸 덕분에 그래픽과 텍스트를 게임이 실제로 소비하는 경로를 잡았다. 분석만 계속 파는 단계는 여기서 마무리한다. 다음 기록부터는 한글 글리프 교체, 문자열 재삽입, 화면 검증처럼 실제 패치 제작 결과를 올릴 생각이다.
이번 분석의 결론을 한 줄로 적으면 이렇다.
그럴듯하게 보이는 결과보다, 게임이 실제로 읽고 출력하는 코드를 끝까지 따라가는 것이 훨씬 빠르다.
'한글화 프로젝트 > 파워프로군 포켓 시리즈' 카테고리의 다른 글
| [개발 중·패치 첨부] DS 코시엔 한글화 — 선수 탭 깨짐·공유 타일·대전 화면 보완 (0) | 2026.10.09 |
|---|---|
| [개발 중] DS 코시엔 한글패치 — 이미지 라벨 359개 상태 보완과 통합 빌드 (0) | 2026.10.04 |
| [개발 중] 모여라! 파워프로군의 DS 코시엔 한글패치 — 메뉴 이미지·외출 화면 보완 (0) | 2026.10.01 |
| [PP9 분석] 파워프로군 포켓 9 한글화 — 6,341건 삽입과 누락 텍스트 추적 (0) | 2026.09.05 |


